AI search: medir y mejorar
Contenido, datos y código originales, escritos a partir de investigación propia y de práctica con sistemas reales.
El curso de AI Engineering terminó con un buscador de CVs que funciona: búsqueda híbrida, RAG, agente, guardrails. El de Evals enseñó a medir si un cambio mejora o empeora un sistema. Este junta los dos: ¿qué está fallando en la búsqueda, y qué cambio lo arregla? Cada módulo empieza midiendo, prueba una técnica y mira si los números se mueven. Si no se mueven, la técnica se quita.
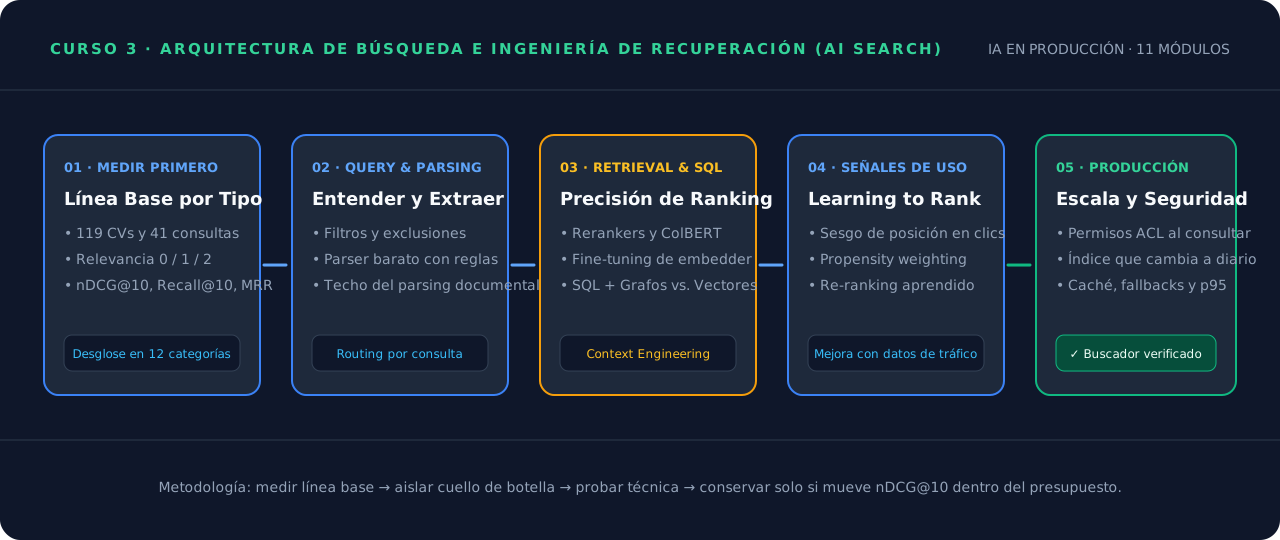
El proyecto: el buscador, ahora con usuarios
El buscador de CVs pasa de 10 CVs a 119, y de "funciona en el demo" a "lo usan reclutadores que escriben como escriben": con paráfrasis, abreviaturas, erratas, requisitos numéricos, exclusiones y en inglés.
- El corpus (
comun/as_cvs.json): 119 CVs de 12 roles, generados desde los hechos (curso de Evals, Módulo 3). Cada CV trae sus hechos (rol, tecnologías, trabajos con años, nivel, ciudad, remoto, inglés, certificaciones), que son la verdad contra la que se mide. - Las consultas (
comun/as_consultas.py): 41 consultas de 12 tipos con relevancia graduada (2, 1, 0) calculada en código desde los hechos. - Los eventos (Módulo 7): sesiones simuladas de reclutadores con sus clics, para aprender de lo que hacen los usuarios.
Mapa del curso
| # | Módulo | La pregunta que responde |
|---|---|---|
| 0 | Qué vamos a mejorar, y con qué datos | ¿Con qué datos se mide cada cambio? |
| 1 | Medir antes de tocar | ¿Dónde está el buscador hoy, por tipo de consulta? |
| 2 | Query understanding y routing | ¿Qué busca de verdad el usuario, y dónde hay que buscarlo? |
| 3 | El parsing le pone techo | ¿Cuánta información se pierde antes de buscar? |
| 4 | Un retrieval que traiga el documento correcto | ¿Rerankers, embeddings afinados o late interaction? |
| 5 | Context engineering y long context | ¿Qué va al contexto, y cuándo conviene meterlo todo? |
| 6 | Cuándo un grafo o SQL le ganan a los vectores | ¿Qué consultas no son de similitud? |
| 7 | Lo que enseñan los clics | ¿Cómo aprender a ordenar de lo que hacen los usuarios? |
| 8 | Seguridad y permisos | ¿Quién puede ver qué, en un índice que cambia todos los días? |
| 9 | Que no se caiga y que no salga carísimo | ¿Costo, latencia y confiabilidad, medidos? |
| 10 | Proyecto final | Un sistema medido antes y después |
Cómo usarlo
Cada módulo incluye manual (README.md), ejercicios con solución (ejercicios.md), autoevaluación y los scripts completos en code/. Puedes leer y hacer las autoevaluaciones en la web del curso, y descargar el .zip del curso para ejecutar los scripts en tu máquina (pip install -r requirements.txt y tu clave OPENAI_API_KEY en .env). Los laboratorios reutilizan las piezas base de los otros dos cursos (el trazador, la caché de llamadas, el BM25 y el embedder, ya incluidos en la descarga) y guardan sus resultados en curso-ai-search/salida/.
Empieza por el Módulo 0.